从800G到1.6T:AI数据中心高速以太网面临哪些测试挑战?
什么是AI数据中心中的高速以太网?
高速以太网构成了现代AI数据中心的通信骨干,将分布式超大规模环境中的数千颗GPU和AI加速器连接起来。它能够实现大规模AI训练和推理工作负载所需的高速数据传输,支持计算集群内扩展、跨机架扩展,以及整个数据中心网络Fabric范围内的规模扩展。
与传统企业网络不同,AI网络中的流量主要来自分布式计算节点之间的东西向通信。
这类环境依赖高度同步、低时延的数据交换。数千颗GPU并行运行,需要始终保持紧密协同。随着AI基础设施持续演进,以及量子计算等新兴领域开始提出新的网络需求,高速以太网也需要在更大规模下持续提供稳定、一致的网络性能。
为什么AI工作负载会对网络性能提出更高要求?
在大规模AI集群和超大规模AI数据中心中,网络性能会直接影响任务完成时间。
AI流量具有多项具有挑战性的特征:高度同步、经常以突发形式出现并迅速占满链路、对丢包的容忍度很低,同时对时延,尤其是尾时延(Tail Latency)高度敏感。
这些因素共同作用,使AI网络和以太网Fabric成为决定整个系统效率的重要因素。
随着AI集群规模持续扩大,任务执行过程中越来越多的时间被用于节点之间的通信,而非计算本身。因此,网络效率正在成为影响应用性能的关键因素。
面向AI,向800G和1.6T演进
400G带来了什么?
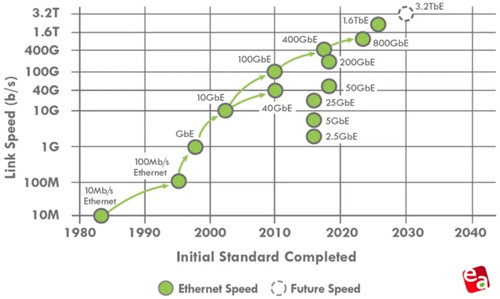
400G Ethernet引入PAM4调制,并推动了第一代超大规模Leaf-Spine网络架构的发展,为高吞吐量数据中心网络奠定了基础。
为什么800G Ethernet已广泛应用于AI数据中心?
800G Ethernet在此基础上将单通道速率提升至100Gbps。
它能够支持更高的交换机端口密度和转发容量,同时通过增强的前向纠错(FEC)技术保障信号完整性。目前,800G已广泛应用于超大规模AI环境。
然而,随着AI工作负载持续增长,即使是800G基础设施,在超大规模环境中也正在逐渐接近其能力边界。
1.6T Ethernet带来了哪些变化?
1.6T Ethernet是高速以太网演进的下一步,通过200Gbps单通道速率和更高密度的交换架构,将整体容量提升一倍。
这使AI集群能够在分布式高性能环境中进一步扩展,但与此同时,也带来了新的技术挑战。
在1.6T环境下,信号裕量进一步缩小,光学器件的功耗要求提高,系统对于各种链路损伤也更加敏感,因此验证工作显著复杂化。
如何在真实工作负载条件下保持稳定、一致的性能,成为关键问题。这也要求工程团队重新思考下一代网络的基准测试、验证和优化方法,以应对网络Fabric从 400G、800G向1.6T持续演进。
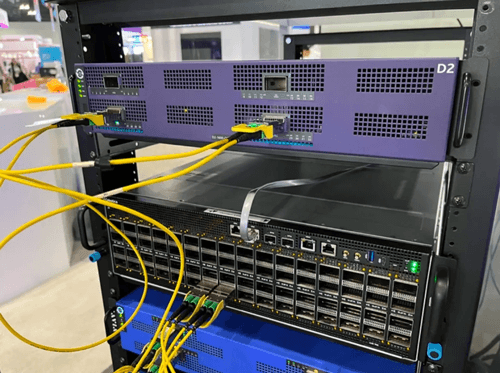
为什么800G和1.6T的网络验证会变得更加复杂?
随着以太网速率不断提升,传统验证方法的有效性也在下降。
在800G,尤其是1.6T环境下,需要面对更高通道速率下的信号完整性问题、多厂商生态之间的互通问题,以及在真实AI工作负载条件下处理网络拥塞的能力。
与此同时,时延和丢包对于分布式AI训练性能的影响也变得更加明显。
因此,要预测AI数据中心的实际性能,验证策略需要尽可能真实地反映AI网络系统和以太网Fabric的运行方式,而不能仅依赖理想条件下的吞吐量测试。
如何跨不同网络层级测试高速以太网?
AI数据中心中的高速以太网验证涉及网络协议栈的多个层级,每个层级都会对整体性能产生影响。
在较低层级(L0–L1),测试主要关注数据的物理传输,包括光、电信号质量、PAM4调制以及前向纠错。
在网络层(L2–L3),验证重点包括整个Fabric中的交换、路由和拥塞行为。
更高层级则需要评估传输和应用行为如何影响实际工作负载的执行。
理解这些层级之间的相互影响非常重要,因为物理层出现的问题可能逐级向上传递,并最终影响应用层性能。
| 网络层级 | 主要测试内容 |
| Layer 0–Layer 1 | 光、电信号完整性,PAM4,FEC |
| Layer 2–Layer 3 | 交换、路由、拥塞行为 |
| Layer 4+ | 传输性能和应用行为 |
AI以太网Fabric的关键验证方法
AI以太网Fabric的验证需要结合物理层、网络层和工作负载层的多种测试方法。
如何验证物理层(L0–L1)?
物理层验证主要关注决定信号质量和可靠性的关键指标,包括:
● 误码率(BER)
● PAM4信号完整性和眼图质量
● 前向纠错(FEC)性能
● 通用管理接口(CMIS)
● SerDes与Intersublayer Link Training(ILT)
● 功耗和散热特性
这些测量对于800G和1.6T尤为重要,因为即使是较小的链路损伤,也可能显著影响整个网络的性能。
如何验证网络和Fabric性能(L2–L3)?
在网络层,验证需要评估Fabric在实际负载条件下的运行表现,而不仅仅是在理想条件下进行测试。
其中包括评估网络转发性能、拥塞管理机制、丢包行为,以及在RoCEv2 Fabric等环境中验证 Ultra Ethernet Transport(UET)等新兴传输架构。
为什么AI工作负载仿真对测试非常重要?
AI工作负载产生的流量模式与传统网络测试场景存在根本性差异。
尤其是在AI数据中心和超大规模环境从400G、800G向1.6T Fabric 演进的过程中,这种差异变得更加明显。
验证工作越来越需要复现All-Reduce等集合通信操作,以及大量端点之间的同步流量。
这些流量模式能够产生较大的网络压力,从而暴露传统测试中难以发现的拥塞、时延和规模扩展问题。
为什么使用仿真,而不是直接使用物理GPU集群?
在产品开发早期,使用真实GPU集群进行测试往往并不现实。
一方面,大规模GPU集群成本较高;另一方面,测试规模和环境很难精确控制,而且同一场景往往难以重复复现。
仿真则提供了一种更加高效的方法。
通过构建可控、可重复的测试场景,可以模拟大规模AI流量,并在产品实际部署之前分析网络行为,从而帮助工程团队在开发生命周期的更早阶段发现性能瓶颈。
测试平台在高速以太网验证中发挥什么作用?
对超大规模数据中心中的AI以太网Fabric进行有效验证,通常需要将物理层分析与大规模流量仿真结合起来。
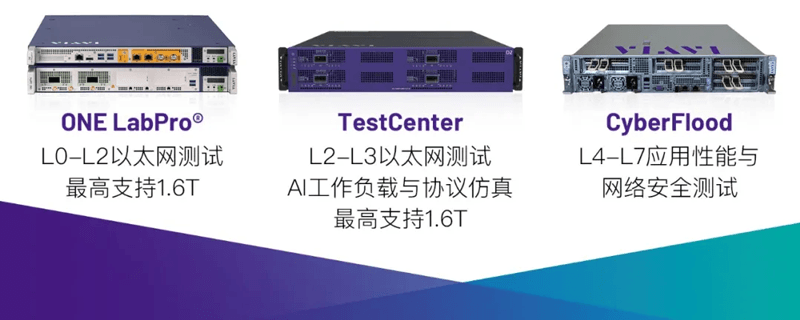
ONE LabPro等物理层测试平台可用于验证光、电接口性能,包括信号完整性、调制特性和 FEC效率。
这些工具主要工作在组件和接口层面,可帮助工程人员深入了解信号和设备的实际表现。ONE LabPro可在单个模块上同时支持 RHS(Riding Heat Sink)和IHS(Integrated Heat Sink)。
TestCenter等流量生成和网络仿真平台,则可以模拟多种AI工作负载,并评估网络Fabric在真实条件下的运行表现,其中包括拥塞分析、时延测量以及大规模流量建模。
针对AI推理测试,CyberFlood可以进一步覆盖单纯Fabric测试无法触及的业务服务路径。
CyberFlood能够生成真实、有状态的Layer 4–7流量,在实际生产条件下验证AI推理系统的性能、可扩展性和弹性,并以Tbps级流量模拟大语言模型(LLM)以及其他AI驱动型工作负载,帮助团队在正式部署之前验证基础设施是否能够满足实际运行要求。
将这些不同测试方法结合起来,可以获得贯穿整个网络栈的可视性,从而更加完整地了解网络性能。
塑造AI网络未来的技术趋势
多项技术正在推动高速以太网不断发展,同时也在改变未来的网络验证需求。
其中许多创新都是为了帮助AI网络更好地实现Scale Up、Scale Out,并在更加分布式的环境中持续扩展。
AI网络架构
● Ultra Ethernet Transport(UET)
UET是专门面向AI和HPC工作负载设计的传输架构,通过多路径和更加灵活的数据包传输机制提升网络效率和可扩展性。
随着UET的应用逐步扩大,对于规范符合性、互通性以及性能测试的需求也将随之增加,以验证多厂商环境下的不同实现,并确保部署的可靠性。
● 光电路交换机(OCS)
光电路交换机正在受到AI集群领域越来越多的关注。通过动态重新配置网络拓扑,OCS可以帮助大型GPU环境降低网络拥塞。
光互连技术演进
● 线性可插拔光学(LPO)
LPO通过减少DSP的使用来降低功耗和时延,但同时对系统调优提出了更加严格的要求。
● 近封装光学(NPO)
与传统可插拔光学方案相比,NPO有望进一步降低功耗,同时保持一定的灵活性,并可能成为传统可插拔光学向共封装光学演进过程中的重要过渡技术。
● 共封装光学(CPO)
CPO将光学器件与交换芯片集成在一起,以提升系统效率,但同时也增加了设计和验证的复杂性。
● 外置激光小型可插拔模块(ELSFP)
ELSFP将激光光源与收发器分离,有助于改善散热效率,并支持下一代系统中更高密度的光学设计。
● 相干光技术(ZR/ZR+/XR)
相干光技术正从传统的数据中心互联场景进一步向AI Fabric扩展,可支持更长传输距离、更高的带宽效率,以及更加灵活的网络架构。
基础设施规模扩展
● 空芯光纤(Hollow-Core Fiber)
空芯光纤具有更低时延和更低衰减等特点,同时也带来了新的测量和测试要求。
● 多芯光纤(MCF)
多芯光纤能够在一根光纤内部提供多个空间通道,有望在提升带宽密度的同时减少超大规模数据中心中的布线空间占用。
● 有源电缆(AEC)
AEC越来越多地用于短距离高速互连。在800G及更高速率下,与传统铜缆方案相比,它能够提供更好的信号完整性并降低功耗。
● 3.2T Ethernet及更高速率
3.2T Ethernet以及后续更高速率将进一步提高网络吞吐量,同时也会放大目前已经存在的信号完整性和规模扩展挑战。
这些趋势表明,未来仍将持续需要更加先进、更加集成的验证策略。
高速以太网如何支撑大规模AI性能?
高速以太网是决定AI数据中心及超大规模AI网络环境性能的重要基础,而随着AI工作负载持续扩展,其重要性还将进一步提高。
随着网络向800G和1.6T演进:
● AI网络和以太网Fabric对整个系统效率的影响越来越大;
● 验证需要在规模化条件下真实反映AI网络的流量模式;
● 测试需要覆盖AI以太网协议栈中的物理层、网络层和工作负载层。
将深入的物理层分析与大规模流量仿真结合起来,可以更加准确、完整地评估AI以太网Fabric,并帮助确保大规模环境下的网络性能和可靠性。
VIAVI如何帮助网络设备制造商实现规模扩展?
随着网络设备制造商不断设计和部署面向AI的基础设施,测试能力也必须跟上不断提升的网络速率、端口密度和架构复杂度。
VIAVI可提供覆盖物理层和网络Fabric的验证能力,帮助工程团队在产品开发生命周期的更早阶段发现性能瓶颈、互通问题以及规模扩展方面的挑战。
ONE LabPro和TestCenter等平台在整个网络栈中提供相互补充的测试能力。
ONE LabPro支持最高1.6T的高速以太网验证,并集成物理层、FEC和多流量分析能力,可满足组件级和系统级测试需求。
TestCenter提供大规模流量生成和协议仿真能力,可针对AI Fabric、交换行为以及大规模拥塞场景进行更加真实的验证。
这些能力相结合,可以帮助网络设备制造商在真实条件下验证系统性能、降低开发风险,并更加高效地扩展AI网络解决方案,从而帮助AI网络在规模化部署中保持稳定的性能、可靠性和效率。
(以上文章内容源自:微信公众号V粉看唯亚威)
德科仕通信是美国VIAVI公司中国区总代理,经销航电测试等多种高端通信测试设备,如想了解更多产品信息,欢迎垂询相关产品业务,电话400-699-8180。